2. 遺伝子とRNA
遺伝子は、RNAを作る情報を持つDNAの領域です。タンパク質を作る遺伝子では、情報がmRNAに写され、それをもとにタンパク質が作られます。
DNA → mRNA → タンパク質
DNAからRNAを作るのが転写、mRNAからタンパク質を作るのが翻訳です。
RNA量から、遺伝子の発現量を調べられます。
3. RNA-seqの仕組み
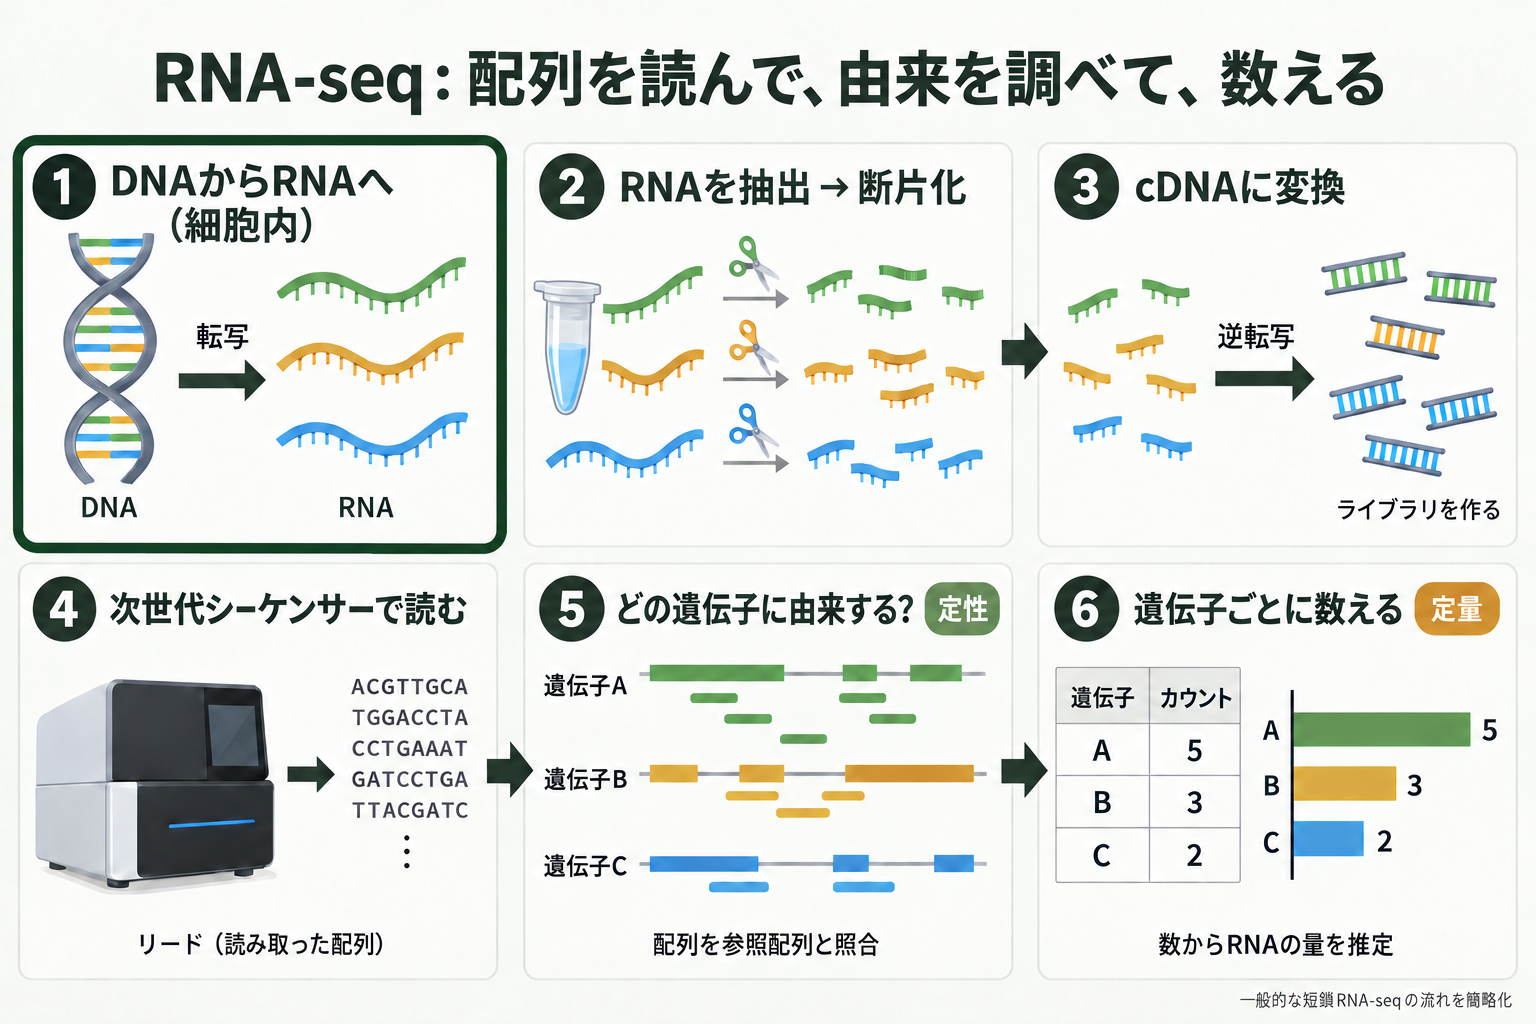
一般的な短鎖RNA-seqでは、サンプルからRNAを抽出・断片化し、cDNAに変えて配列を読みます。読み取った配列をリードと呼びます。
リードを参照配列と照合して由来する遺伝子を調べ、遺伝子ごとに数えてRNA量を推定します。
数えた結果を、カウント表にする
表の1行は1遺伝子、1列は1サンプルです。ControlとTreatの各群で複数のサンプルを測り、ばらつきを調べます。
| 遺伝子 | Control-1 | Control-2 | Control-3 | Treat-1 | Treat-2 | Treat-3 |
|---|---|---|---|---|---|---|
| Gene01 | 80 | 97 | 73 | 38 | 14 | 23 |
| Gene02 | 105 | 95 | 89 | 26 | 55 | 60 |
| Gene03 | 135 | 36 | 133 | 126 | 1 | 61 |
| Gene04 | 1 | 137 | 21 | 39 | 219 | 240 |
| Gene05 | 161 | 169 | 201 | 111 | 91 | 93 |
| Gene06 | 169 | 165 | 204 | 112 | 179 | 144 |
| Gene07 | 177 | 253 | 196 | 204 | 178 | 11 |
| Gene08 | 13 | 47 | 31 | 73 | 95 | 137 |
| Gene09 | 98 | 98 | 94 | 175 | 161 | 145 |
| Gene10 | 125 | 88 | 163 | 235 | 258 | 235 |
| Gene11 | 118 | 124 | 150 | 371 | 401 | 271 |
| Gene12 | 79 | 61 | 215 | 525 | 396 | 490 |
| Gene13 | 171 | 206 | 156 | 53 | 45 | 95 |
| Gene14 | 247 | 101 | 210 | 105 | 1 | 61 |
| Gene15 | 95 | 94 | 113 | 13 | 47 | 78 |
| Gene16 | 207 | 86 | 45 | 1 | 97 | 116 |
| Gene17 | 111 | 110 | 124 | 94 | 81 | 96 |
| Gene18 | 103 | 111 | 158 | 182 | 112 | 110 |
| Gene19 | 85 | 137 | 189 | 98 | 181 | 181 |
| Gene20 | 173 | 96 | 255 | 155 | 148 | 337 |
| Gene21 | 198 | 197 | 197 | 356 | 317 | 312 |
| Gene22 | 79 | 115 | 86 | 157 | 178 | 161 |
| Gene23 | 210 | 111 | 112 | 233 | 303 | 232 |
| Gene24 | 10 | 136 | 262 | 355 | 327 | 428 |
| Gene25 | 154 | 126 | 125 | 142 | 147 | 163 |
| Gene26 | 148 | 161 | 245 | 155 | 123 | 124 |
| Gene27 | 149 | 1 | 149 | 168 | 168 | 108 |
| Gene28 | 196 | 142 | 421 | 236 | 275 | 164 |
| Gene29 | 72 | 70 | 69 | 77 | 88 | 83 |
| Gene30 | 101 | 137 | 73 | 93 | 149 | 100 |
| Gene31 | 130 | 95 | 137 | 143 | 64 | 51 |
| Gene32 | 173 | 140 | 84 | 142 | 86 | 233 |
| Gene33 | 178 | 165 | 177 | 171 | 145 | 178 |
| Gene34 | 158 | 13 | 160 | 196 | 197 | 171 |
| Gene35 | 82 | 129 | 195 | 54 | 64 | 271 |
| Gene36 | 28 | 144 | 64 | 155 | 149 | 1 |
| Gene37 | 94 | 71 | 108 | 85 | 78 | 80 |
| Gene38 | 147 | 135 | 146 | 102 | 116 | 121 |
| Gene39 | 20 | 310 | 177 | 156 | 73 | 222 |
| Gene40 | 174 | 71 | 414 | 230 | 198 | 248 |
| Gene41 | 213 | 217 | 212 | 177 | 151 | 144 |
| Gene42 | 160 | 172 | 195 | 115 | 161 | 225 |
| Gene43 | 70 | 29 | 97 | 68 | 84 | 76 |
| Gene44 | 190 | 200 | 5 | 85 | 101 | 114 |
| Gene45 | 118 | 116 | 120 | 138 | 141 | 144 |
| Gene46 | 126 | 154 | 180 | 163 | 180 | 112 |
| Gene47 | 177 | 194 | 236 | 108 | 111 | 161 |
| Gene48 | 524 | 280 | 141 | 84 | 149 | 165 |
問題:このまま比較してよい?
Gene01の発現量に、Control群とTreat群で差があるかを知りたいとします。
この値が正規化前のカウントなら、そのまま比較して発現量の差を判断してよいでしょうか?
答え・解説を見る
× そのまま比較してはいけません。
カウントは、RNAの量だけでなく、サンプルごとに読み取ったリードの総数にも左右されます。たとえば、RNAの割合が同じでも、読み取る総数が2倍なら、その遺伝子のカウントもおおむね2倍になります。
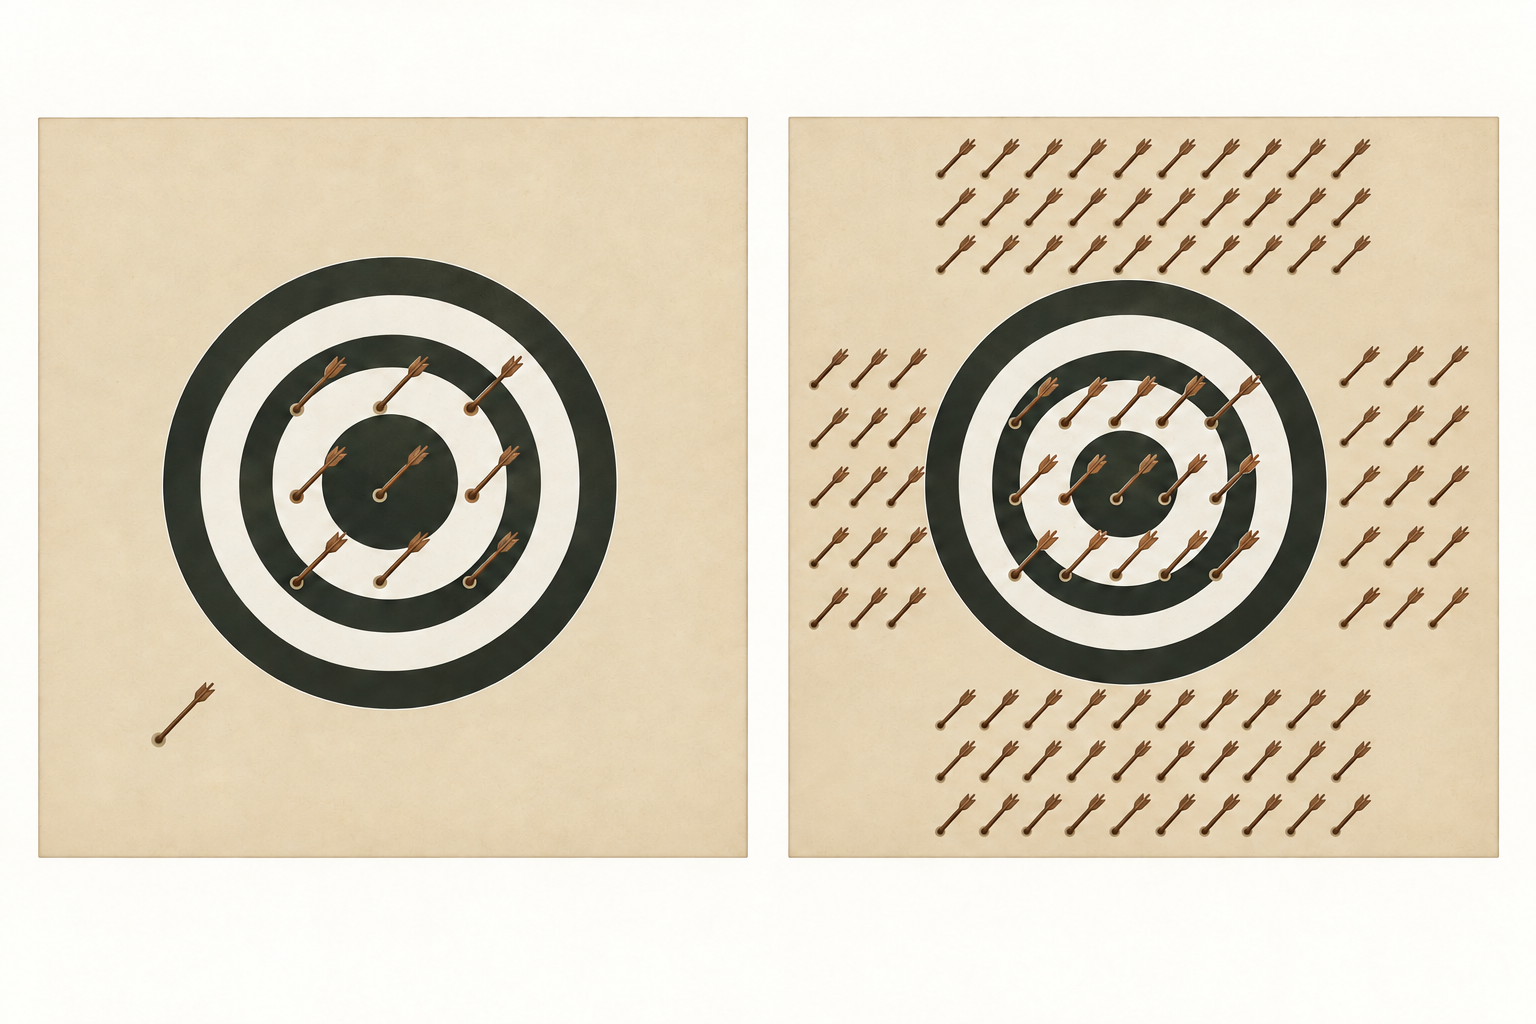
「当たった本数」は右のほうが多いですが、試行回数を考慮した「命中率」は左のほうが高くなります。
また、一部のRNAが多いと、ほかのRNAに割り当てられるリードの割合も変わります。こうした読み取り量やRNAの構成の違いを考慮し、サンプル間で比べられるようにする処理が正規化です。
代表的な解析ソフトのDESeq2は、正規化を考慮して検定し、群間で発現量が有意に変動する遺伝子を調べます。
4. 発現量の変化
fold changeは、Treatの平均発現量をControlの平均発現量で割った比です。log₂ fold changeは、その比を2を底とする対数で表します。
| Treat / Control | log₂ fold change | 意味 |
|---|---|---|
| 2 | +1 | Treatで2倍 |
| 1 | 0 | 同じ |
| 0.5 | −1 | Treatで半分 |
正ならTreatで多く、負ならTreatで少なくなります。比較の向きを逆にすると、符号も逆になります。
5. p値と多重検定
平均が違っても、サンプルのばらつきで説明できるかもしれません。p値は、差がないという仮定と検定の前提のもとで、観測された差以上に極端な結果が出る確率です。
多くの遺伝子を同時に調べると、偶然小さなp値も増えます。そこでBenjamini–Hochberg(BH)法などでp値を調整します。
DESeq2の結果を表で見る
DESeq2の結果表には、遺伝子ごとの発現量の変化やp値が並びます。比較の向きはTreat / Controlです。
| 遺伝子名 | baseMean | log2FoldChange | p-value | padj |
|---|---|---|---|---|
| Gene01 | 120.0 | −1.00 | 0.001 | 0.005 |
| Gene02 | 250.0 | +1.50 | 0.004 | 0.010 |
| Gene03 | 85.0 | +0.10 | 0.650 | 0.650 |
| Gene04 | 180.0 | −0.80 | 0.030 | 0.050 |
| Gene05 | 60.0 | +0.30 | 0.200 | 0.250 |
列の読み方を示す架空の数値です。
- 遺伝子名:どの遺伝子の結果かを示します。
- baseMean:正規化したカウントの、全サンプルでの平均です。
- log2FoldChange(Log2FC):発現量の変化をlog₂で表した値です。
- p-value:群間の差を検定したp値です。DESeq2の列名は
pvalueです。 - padj:多重検定を考慮した調整済みp値です。DESeq2では標準でBH法を使います。
列の定義:DESeq2の公式解説
6. ボルケーノプロット
表の1行を、図の1点にします。1点は1遺伝子です。
log₂ fold change
変化の方向と大きさ。左はTreatで少なく、右はTreatで多い。
−log₁₀ 調整済みp値
上に行くほど調整済みp値が小さい。
遺伝子の表とボルケーノプロット
塗りつぶした点は、調整済みp値が0.05未満、かつ|log₂ FC|が1以上の遺伝子を示します。
| 遺伝子 | log₂ FC | 調整済みp |
|---|---|---|
| -1.75 | 0.010 | |
| -1.36 | 0.010 | |
| -1.30 | 0.104 | |
| +0.87 | 0.325 | |
| -0.57 | 0.016 | |
| -0.24 | 0.233 | |
| -0.22 | 0.747 | |
| +0.60 | 0.396 | |
| +0.68 | 0.010 | |
| +1.18 | 0.010 | |
| +1.38 | 0.010 | |
| +1.30 | 0.016 | |
| -1.72 | 0.010 | |
| -1.42 | 0.071 | |
| -0.61 | 0.208 | |
| -0.73 | 0.464 | |
| -0.40 | 0.010 | |
| -0.13 | 0.733 | |
| -0.52 | 0.397 | |
| +0.11 | 0.876 | |
| +0.64 | 0.010 | |
| +1.06 | 0.010 | |
| +0.95 | 0.016 | |
| +1.87 | 0.010 | |
| +0.11 | 0.325 | |
| -0.46 | 0.030 | |
| -0.14 | 0.876 | |
| -0.60 | 0.396 | |
| +0.06 | 0.692 | |
| +0.36 | 0.264 | |
| -0.25 | 0.718 | |
| -0.27 | 0.733 | |
| +0.02 | 0.906 | |
| +0.34 | 0.448 | |
| -0.15 | 0.876 | |
| -0.09 | 0.906 | |
| +0.04 | 0.876 | |
| -0.30 | 0.126 | |
| -0.17 | 0.876 | |
| +0.15 | 0.876 | |
| -0.33 | 0.042 | |
| -0.07 | 0.876 | |
| -0.11 | 0.876 | |
| -0.47 | 0.690 | |
| +0.14 | 0.337 | |
| -0.03 | 0.906 | |
| -0.79 | 0.104 | |
| -0.02 | 0.972 |
Gene01
基準を満たす・Treatで減少
- log₂ fold change
- -1.75
- Treat / Control
- 0.30 倍
- 調整済みp値(BH)
- 0.010
発現量の変化だけでは、原因や働きまでは分かりません。
データの生成条件と計算方法
全48遺伝子、ControlとTreatを各6反復。独立な正規乱数を整数に丸め、1未満は1とした任意単位の模擬発現量です。乱数シードは20261023。基準量は80〜200、標準偏差は基準量の0.12 / 0.25 / 0.45 / 0.65倍。Treatの期待値は、最初の24遺伝子では基準量×2のe乗(e = −1.6 + (0始まりの番号 mod 12)×0.29)、残りはe = (番号 mod 5 − 2)×0.07です。
横軸は反復平均の比のlog₂。p値は12個の値を6対6に分ける全924通りの、平均差の絶対値を使った両側の正確置換検定から計算し、全48検定をBH法で調整しています。ライブラリサイズの正規化やRNA-seq特有の分布を扱う解析ではなく、統計的な指標を読むための簡略例です。実データの解析には、その実験に合った手法が必要です。
選択中のGene01:Control [80, 97, 73, 79, 73, 87]、Treat [38, 14, 23, 34, 16, 20]。
7. GSEA
GSEA(遺伝子セットエンリッチメント解析)は、遺伝子セット(ある働きに関わる遺伝子の集まり)が、順位の上位か下位に偏るかを調べます。順位は発現量の変化などで決めます。
カレーの材料の位置を、1本の曲線にする
序論と同じ121商品を「夏 ÷ 冬」が大きい順に並べます。左からたどり、カレーの材料11品では曲線を上げ、それ以外では下げます。
ここまでの割合の差10/11 − 24/110 = +0.69
34位までに材料11品のうち10品が現れ、曲線は頂点に達します。残る米は64位。曲線はそこまで下がり、米の位置で少し上がってから0に戻ります。
縦軸は、何を足し引きした値?
縦軸は、左から順に足し引きした累積スコア(running ES)です。0から始め、材料なら1/11を足し、それ以外なら1/110を引きます。
材料で足す量と、それ以外で引く量はそれぞれ合計1なので、最後は0に戻ります。0より上なら、材料11品のうちそこまでに現れた割合が、その他110品のうちそこまでに現れた割合を上回っています。縦軸は売上金額や増減率ではありません。
0から最も離れた点の値がエンリッチメントスコア(ES)です。この例は34位で約+0.69。正なら上位、負なら下位に材料が偏っています。
商品を遺伝子に、レシピを遺伝子セットに置き換える
GSEAの図でも、縦線はセット内の遺伝子の位置を示します。曲線の山や谷と合わせて、順位のどちら側に集まるかを見ます。
次の図では、48遺伝子をlog₂ fold changeの大きい順に並べます。左はTreatで増加、右は減少。「セットA」は左側に多く、右側にも一部がある16遺伝子の模式セットです。
遺伝子の順位とセットA
| 順位 / 遺伝子 | log₂ FC |
|---|---|
| 01◆Gene24 | +1.87 |
| 02◆Gene11 | +1.38 |
| 03◆Gene12 | +1.30 |
| 04◆Gene10 | +1.18 |
| 05◆Gene22 | +1.06 |
| 06◆Gene23 | +0.95 |
| 07◆Gene04 | +0.87 |
| 08◆Gene09 | +0.68 |
| 09·Gene21 | +0.64 |
| 10◆Gene08 | +0.60 |
| 11·Gene30 | +0.36 |
| 12◆Gene34 | +0.34 |
| 13·Gene40 | +0.15 |
| 14·Gene45 | +0.14 |
| 15·Gene20 | +0.11 |
| 16·Gene25 | +0.11 |
| 17·Gene29 | +0.06 |
| 18·Gene37 | +0.04 |
| 19·Gene33 | +0.02 |
| 20·Gene48 | -0.02 |
| 21·Gene46 | -0.03 |
| 22·Gene42 | -0.07 |
| 23·Gene36 | -0.09 |
| 24·Gene43 | -0.11 |
| 25·Gene18 | -0.13 |
| 26·Gene27 | -0.14 |
| 27·Gene35 | -0.15 |
| 28·Gene39 | -0.17 |
| 29·Gene07 | -0.22 |
| 30·Gene06 | -0.24 |
| 31·Gene31 | -0.25 |
| 32·Gene32 | -0.27 |
| 33·Gene38 | -0.30 |
| 34·Gene41 | -0.33 |
| 35·Gene17 | -0.40 |
| 36·Gene26 | -0.46 |
| 37·Gene44 | -0.47 |
| 38·Gene19 | -0.52 |
| 39◆Gene05 | -0.57 |
| 40·Gene28 | -0.60 |
| 41◆Gene15 | -0.61 |
| 42·Gene16 | -0.73 |
| 43◆Gene47 | -0.79 |
| 44·Gene03 | -1.30 |
| 45◆Gene02 | -1.36 |
| 46·Gene14 | -1.42 |
| 47◆Gene13 | -1.72 |
| 48◆Gene01 | -1.75 |
開始点セットAで上がり、セット外で下がる
0.00◆はセットA。点線は全48遺伝子をたどった曲線です。0から最も離れた点の値(ES)は+0.56です。
スコアの計算方法
セットAの16遺伝子では1 ÷ 16、それ以外の32遺伝子では−1 ÷ 32を足します。上昇の合計は+1、下降の合計は−1なので、最後は0に戻ります。重みづけ、NES・FDRの計算は行っていません。
セットAは左から12位までに10遺伝子、39位以降に6遺伝子あります。曲線は左で山を作り、中央で0より下がり、右で再び上がります。
山や谷は、順位のどこにできる?
左側に縦線が集まると山、右側に集まると谷ができます。山や谷の位置を縦線と一緒に見ます。以下の模式図は、左がlog₂ fold changeの正、右が負です。
上位に集まる
上位と下位に分かれる
全体に分散する
中央付近に集まる
「上位に集まる」図は、左側に一つの山ができます。「上位と下位に分かれる」図は、左で上がり、中央で下がり、右でまた上がります。山と谷が続くとS字のように見えることがあります。
上位と下位に分かれるセットには、Treatで増えた遺伝子と減った遺伝子の両方があります。理由は曲線だけでは分かりません。この図のESは正ですが、下位にも7遺伝子あります。ES一つでは両側への分布を表せないため、両端の遺伝子を確かめます。
「全体に分散する」図では、曲線は0付近を小さく上下します。「中央付近に集まる」図も、上位・下位のどちらかに集まる形ではありません。
「意味があるか」は、曲線だけでは決まらない
比較の向きと順位づけの値を確かめ、縦線が集まる側を見ます。次に、先頭から山までのセット内遺伝子を調べます。ESが負なら谷から末尾までです。これをleading-edge(リーディングエッジ)と呼びます。上位と下位に分かれる図では、上位側の9遺伝子です。それらの遺伝子について、各サンプルの発現量も確かめます。
セットの定義が、調べたい働きに合うかも確かめます。上位に偏っていても、セット内の遺伝子すべてが増えたことや、その働きの活性化までは分かりません。山の高さだけで統計的な有意性も判断できません。
ここまでの図は、セット内の項目で同じ量を足す「重みなし」の計算です。標準的なGSEAでは、順位づけの指標の絶対値に応じて足す量を変えます。ESを正規化した値がNESです。統計的な評価には置換検定やFDRを使います。
8. 確認問題
RNA量が増えれば、タンパク質の活性も上がる?
そうとは限りません。翻訳やタンパク質の修飾・分解も影響します。
ボルケーノプロットの塗りつぶした点は何を示す?
この図では、調整済みp値が0.05未満、かつ|log₂ fold change|が1以上の遺伝子です。
ESが正なら、セット内の遺伝子はすべてTreatで増えた?
そうとは限りません。セットが上位側に偏ることを示しますが、下位側にある遺伝子もあります。